科研算力
CPU 并行与 GPU 加速资源,从一份算例到持续计算,按软件、体系规模与使用节奏选择。
查看服务细节
- 按任务选资源
- Intel Xeon 8173M、P100、V100,结合算法与显存需求选择。
- 环境与操作指南配套
- 科学软件、提交命令、真实算例和分析工具,衔接完整计算流程。
- 按使用节奏投入
- 核时与 GPU 包月方案,每用户默认免费 500G 存储。
MPI / OpenMP
16 GB / 32 GB 显存
- 准备输入登录与文件传输
- 提交任务选择环境与资源
- 分析结果后处理与绘图
用密度泛函理论优化晶体结构,计算能带、态密度和材料总能量。
从水分子的单点能和结构优化入手,进一步开展第一性原理分子动力学模拟。
选用平面波或数值原子轨道基组,计算材料的电子结构与原子受力。
用经典分子动力学跟踪原子运动,研究材料的形变、扩散和热输运。
优化分子几何结构,计算振动频率,并根据频率结果分析红外光谱。
用量子化学方法研究分子的基态与激发态,分析成键和光谱性质。
从准备拓扑、溶剂化到轨迹分析,模拟蛋白质等生物分子在溶液中的运动。
用第一性原理数据训练深度势模型,验证能量和力的误差,再用于分子动力学模拟。
用 Quantum ESPRESSO 开展平面波赝势计算,从自洽场计算起步,再分析能带与声子。
在 GPU 上运行分子动力学,利用神经网络势研究材料的热导率等输运性质。
CPU 并行与 GPU 加速资源,从一份算例到持续计算,按软件、体系规模与使用节奏选择。
MPI / OpenMP
16 GB / 32 GB 显存
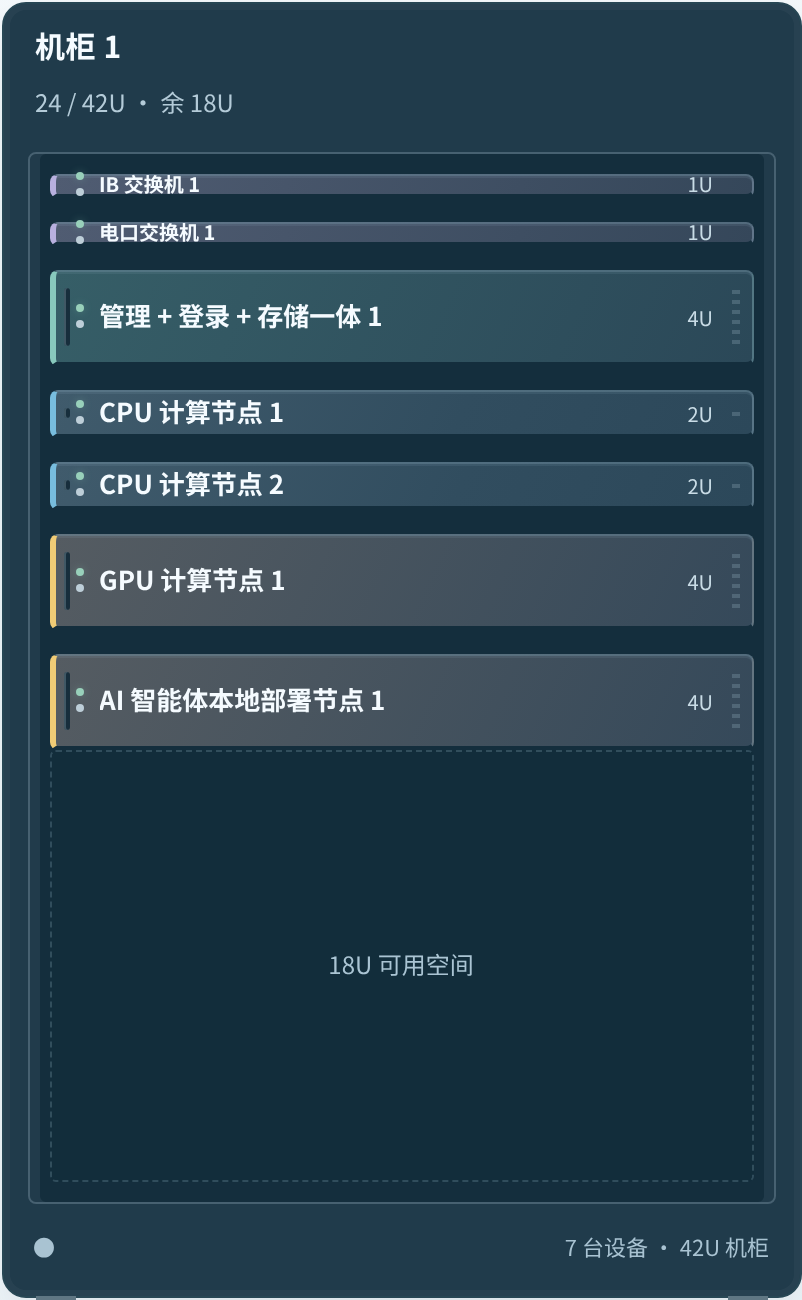
从独立工作站到单柜、多柜计算环境,把计算、存储、互联与软件一起规划。
电脑端可使用交互式配置器,组合你的集群方案。

0.025–0.035 元 / 核时
每用户默认免费 500G 存储
VASP GPU · LAMMPS · DeePMD-kit
VASP 多卡 · GROMACS · 机器学习势
较大体系 · 较高显存需求 · 持续计算
选卡、参数、显存与计算时间,
用实测帮助你找到适合的方案。
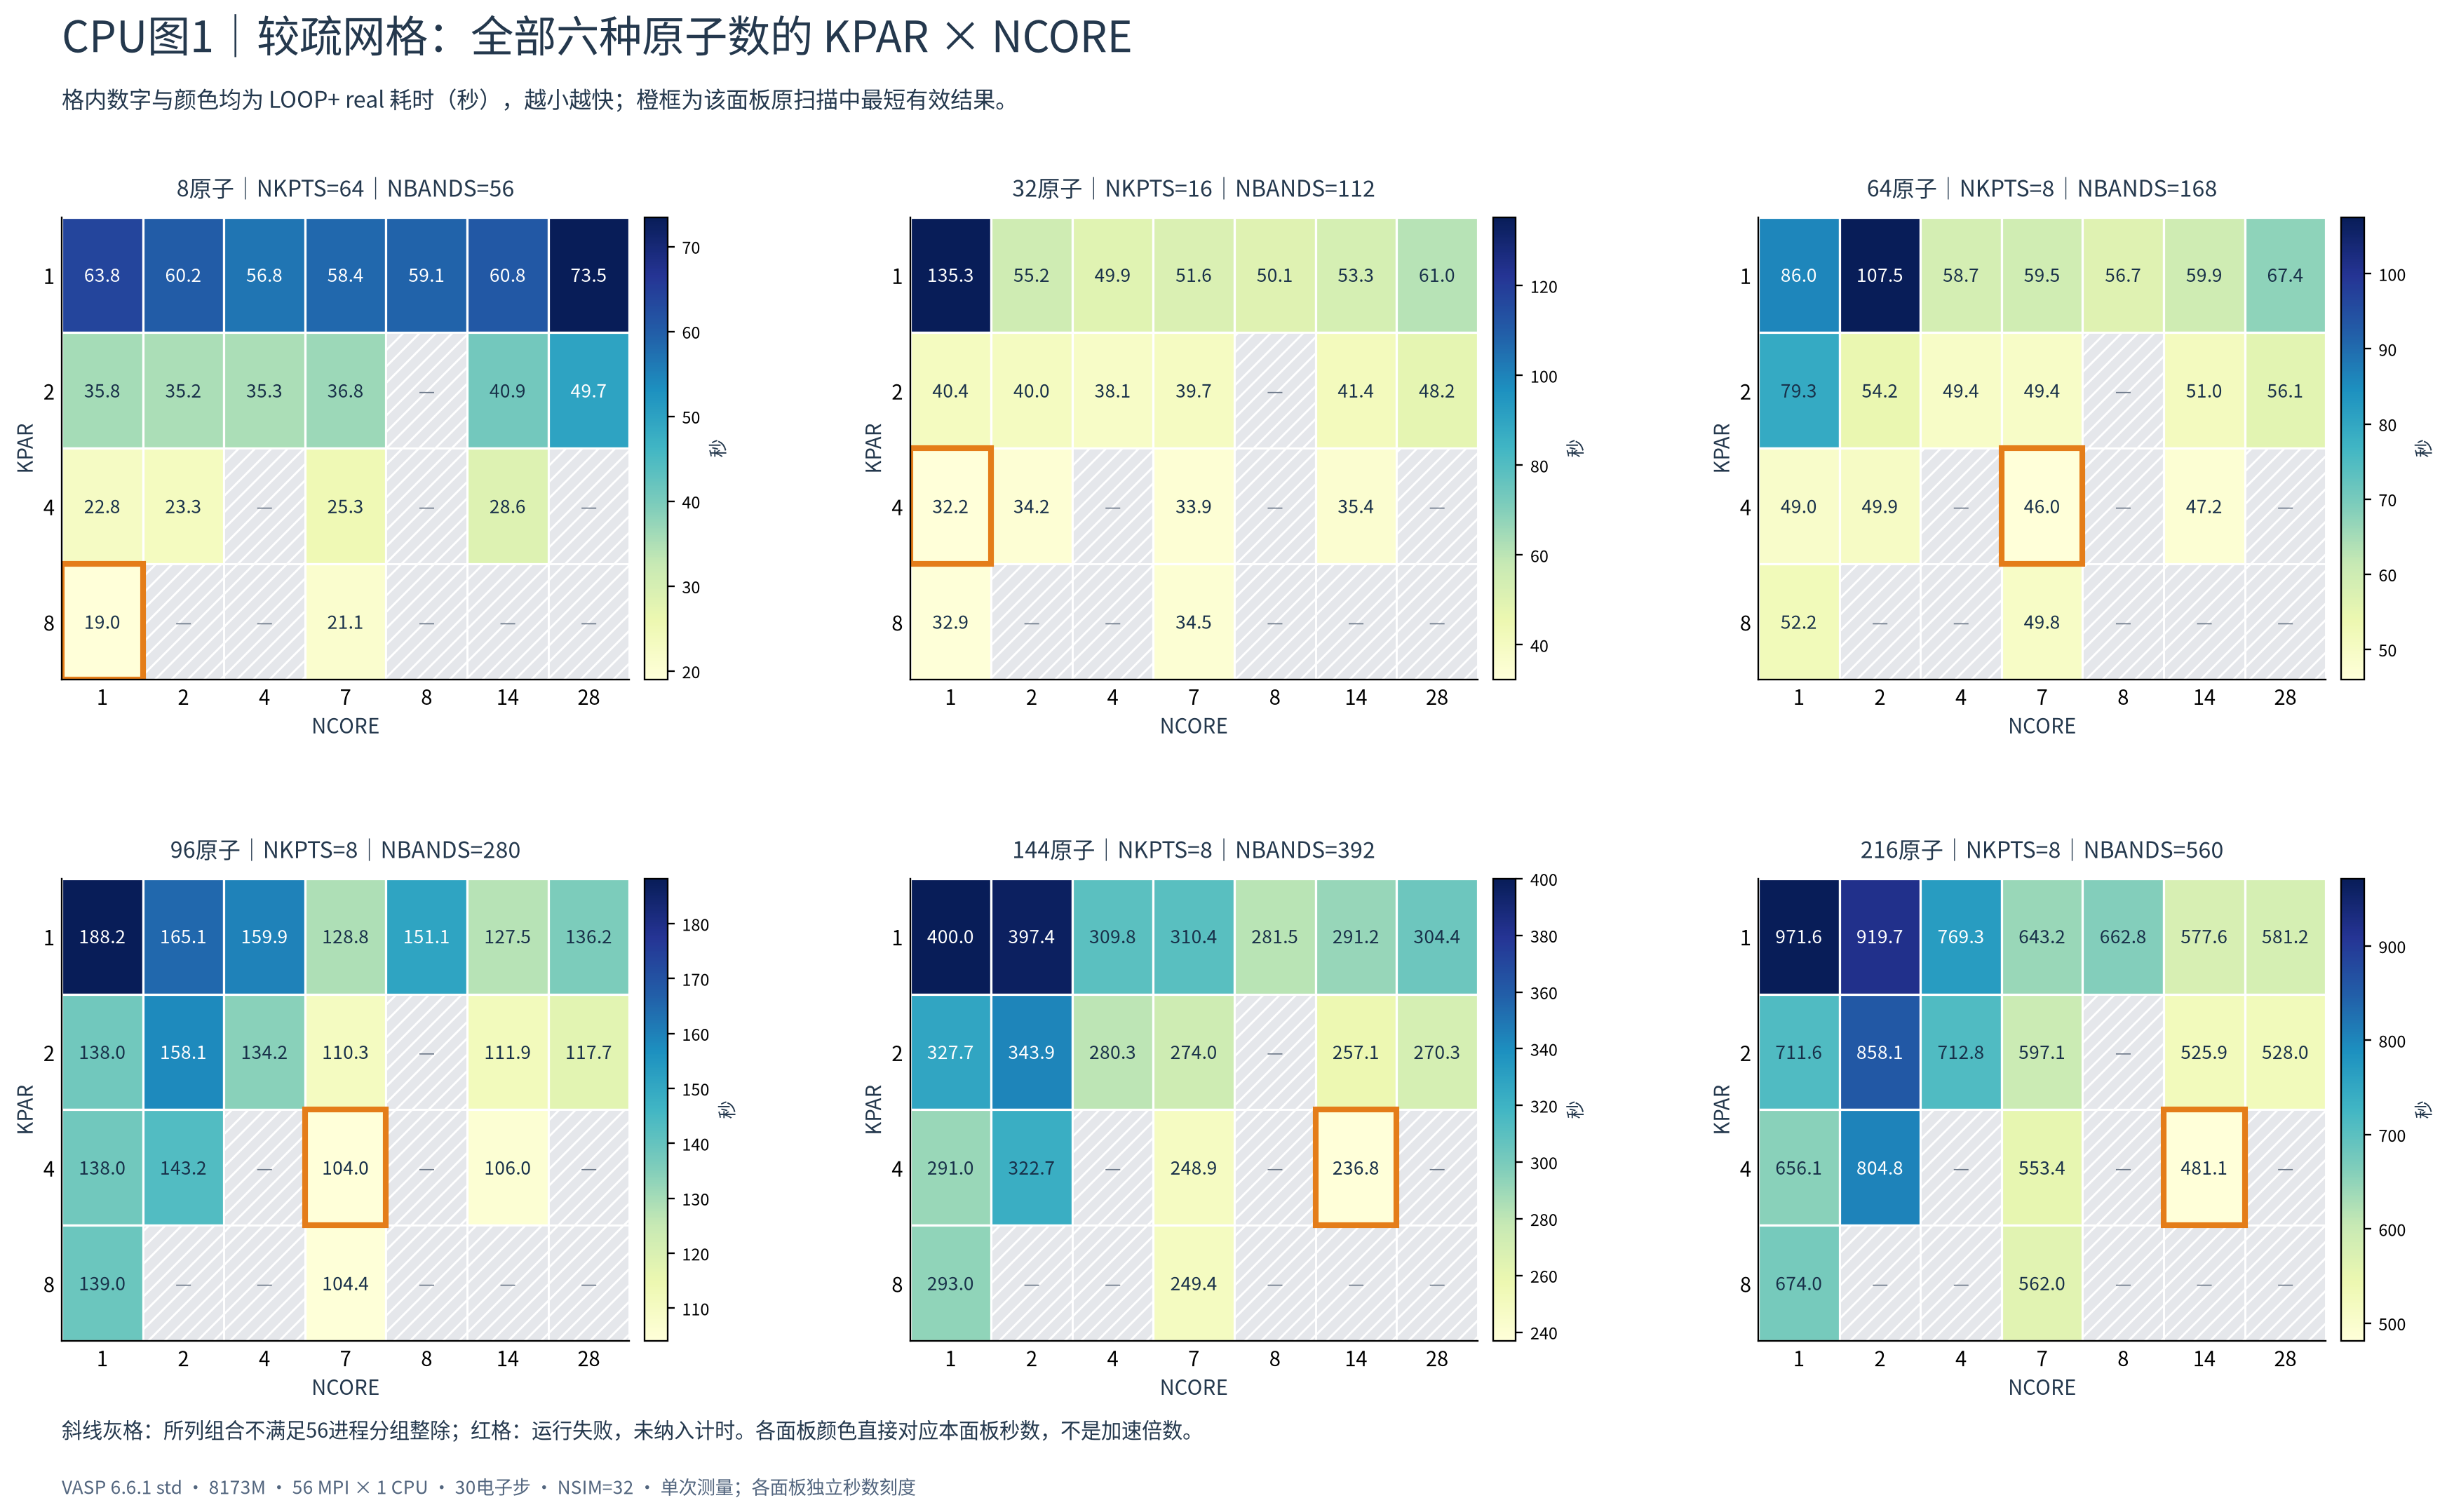
六种Si规模的KPAR × NCORE耗时实测,按自己的体系选择并行参数。

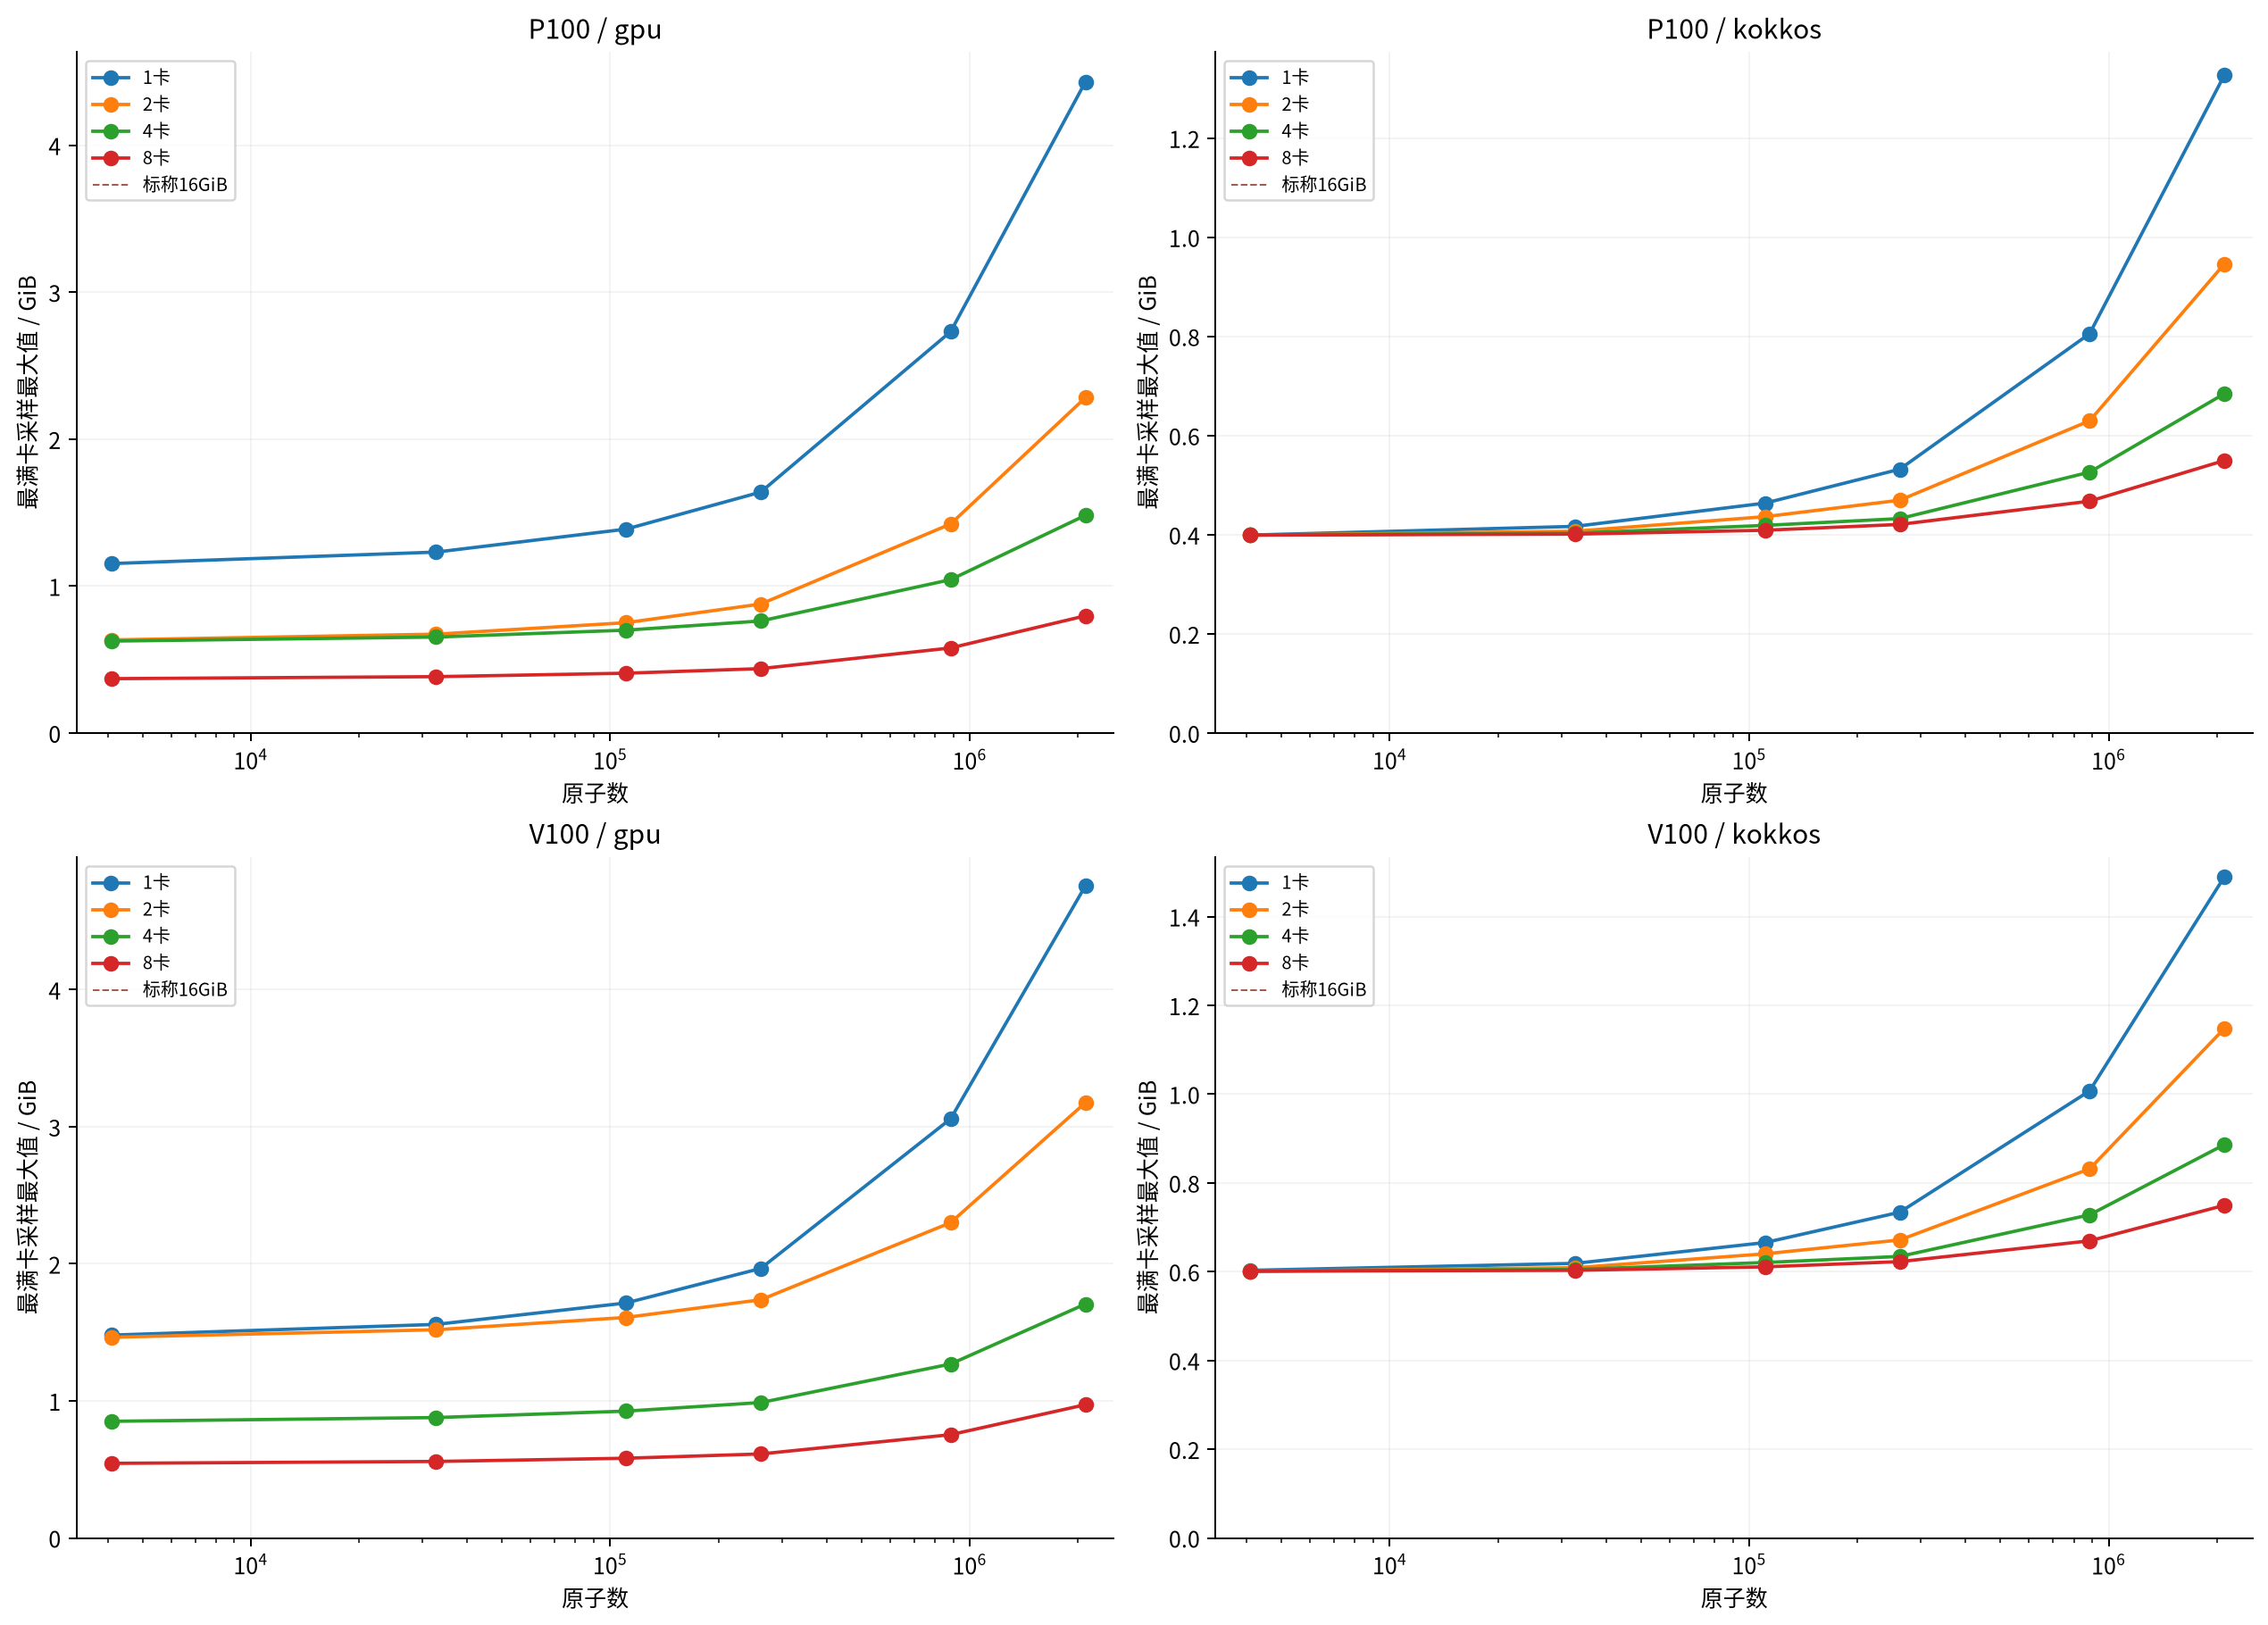
Si/Tersoff的体系规模、卡数与GPU包/KOKKOS显存对照。

图表来自实际测试,完整条件与适用范围见专题正文。